2026最新保姆级教程:从零开始“养龙虾”(附GPT5.4 API接入方法)
广告:如果你想少折腾上游接口,直接把 OpenClaw 接到一个稳定、统一的模型入口上,可以用 api.clawsocket.com。一套 Key 就能接 GPT、Claude、Gemini、Grok,后面给 OpenClaw 扩模型时会轻松很多。
很多人第一次碰 OpenClaw,都不是卡在“能不能装上”,而是卡在装完以后这一串问题:
- OpenClaw 到底应该先跑哪个命令
- onboard 里哪些选项可以先跳过
- 控制台能打开,为什么模型还是不返回
- GPT5.4 API接入方法到底应该写进哪里
你可以把这件事理解成“养龙虾”。壳先搭起来,水先换好,食盆先摆稳,后面它才会正常动。放到 OpenClaw 这里也是一样:先把 CLI 装好,再把 Gateway 和 Dashboard 跑起来,最后把 GPT5.4 API 接进 openclaw.json。
快速结论
- OpenClaw 最稳的安装方式依然是官方安装脚本,自己控 Node 环境的话也可以用
npm install -g openclaw@latest - 真正决定能不能养起来的,不只是安装命令,而是
openclaw onboard、dashboard token 和models.providers - 这篇文章里的 GPT5.4 API接入方法,核心就是把
baseUrl、apiKey、api、models写进~/.openclaw/openclaw.json - 如果你使用 api.clawsocket.com,最省事的 GPT5.4 API接入方法就是走
https://api.clawsocket.com/v1 - 一旦 GPT5.4 API接入方法跑通,后面再往同一个 provider 里加 Claude、Gemini、Grok 只是在模型列表里继续扩而已
什么叫“养龙虾”
这里说的“养龙虾”,不是在讲玩梗,而是方便你理解 OpenClaw 的使用节奏。
OpenClaw 不是一个打开就能聊天的网页产品,它更像一个跑在本机上的 AI 助手框架。你需要先把运行环境搭起来,再把网关、控制台、模型入口和默认工作区配好。
所以“养龙虾”的核心不是装完就结束,而是把装 CLI、跑 onboard、保存 dashboard token、完成 GPT5.4 API接入方法这几件事串起来。只要你把这条链路走通,OpenClaw 后面无论接更多模型,还是接聊天渠道、skills、hooks,都会顺很多。
一、先把“缸”搭起来:安装 OpenClaw
这一步的目标很直接:让 OpenClaw 从“没装”变成“本机有命令、能跑向导”。macOS / Linux / WSL2 最省事的方式是直接走官方安装脚本:
bash
curl -fsSL https://openclaw.ai/install.sh | bash
openclaw --version
如果你已经自己维护 Node,也可以直接改用 npm:
bash
npm install -g openclaw@latest
openclaw --version
截至 2026-03-23,站内现有 OpenClaw 教程统一按 Node 22.16+ 作为最低线来看,Node 24.x 更稳。如果 openclaw --version 都跑不出来,就先别急着研究 GPT5.4 API接入方法,因为模型入口还不是当前阻塞点。
Windows 用户如果想长期稳定用,建议还是优先走 WSL2 环境。原因不复杂:后续守护进程、终端命令、权限模型都会更接近官方文档里的主线路,排错时不容易偏。
二、先别急着喂模型:把 onboard 跑完
bash
openclaw onboard很多人一上来就想研究 GPT5.4 API接入方法,结果连基础配置都没生成,后面自然越改越乱。openclaw onboard 的价值就在这里,它会把 OpenClaw 最基础的骨架先给你搭好,包括:
- 默认 workspace
- gateway 地址和端口
- dashboard token
- 认证方式
- 一些模型与聊天渠道的初始化入口
如果你现在的目标只是尽快把龙虾先养活,我建议向导里采取最小化路线:
| 项目 | 建议选项 | 原因 |
|---|---|---|
| Workspace | 默认路径 | 后面最省事 |
| Gateway 地址 | 本地默认 | 排错简单 |
| Auth | token | 控制台最稳 |
| 上游模型 | 可先跳过 | 后面统一按 GPT5.4 API接入方法手动配置 |
这样做的好处是,OpenClaw 的底座先稳定下来,模型入口再单独处理。你排查问题时,也能明确知道到底是安装层、Gateway 层,还是 provider 层出了问题。
三、保存 token,不然你会以为“龙虾死了”
openclaw onboard 结束以后,终端通常会打印一组很关键的信息,包括 Web UI 地址、带 token 的 dashboard 地址和 Gateway WS 地址。这一步千万别忽略。很多人后面打开控制台看到 token_missing,第一反应是模型坏了,其实只是进错了地址。更稳的做法是把带 token 的那条地址记下来,或者直接以后统一用:
bash
openclaw dashboard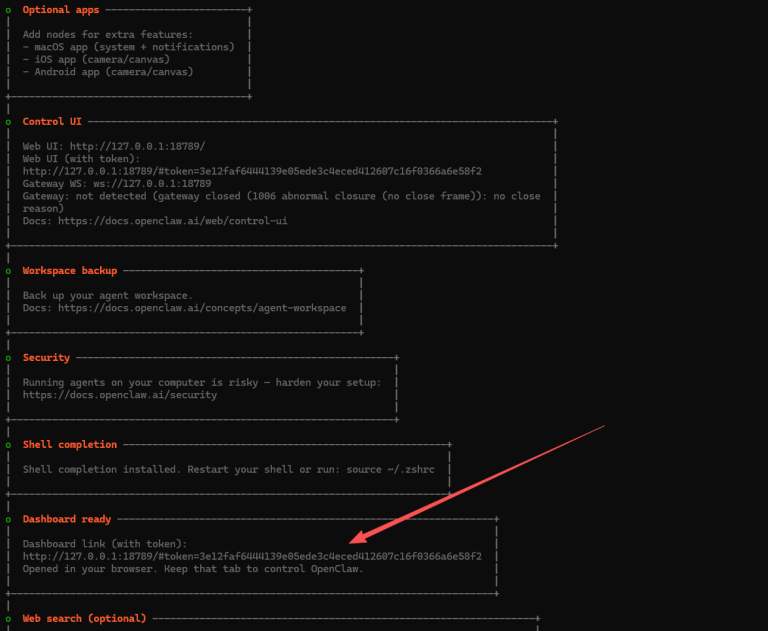
如果控制台能正常打开,但对话不出字,不要急着回头重装。大多数情况下,问题已经进入模型入口层了,也就是下面要讲的 GPT5.4 API接入方法。
四、GPT5.4 API接入方法:先拿到你的 Key
这一步建议你直接按统一入口来做,不要一开始就让 OpenClaw 分别对接多家模型平台。原因很现实:Key 会散,接口格式会杂,后面切模型时你会重复维护很多配置。
办法是先到 api.clawsocket.com 生成自己的 API Key,然后让 OpenClaw 统一从这个入口取模型。
- 登录 api.clawsocket.com
- 打开
令牌管理 - 点击
添加令牌 - 分组选择
default - 生成并复制 API Key
拿到以后,先不要急着把它写死进文件。GPT5.4 API接入方法更稳的习惯是先走环境变量,这样换 Key、换机器、换项目都更容易:
bash
export CLAWSOCKET_API_KEY="你的 API Key"
echo 'export CLAWSOCKET_API_KEY="你的 API Key"' >> ~/.zshrc
source ~/.zshrc
如果你用的是 PowerShell,也可以先在当前会话里测试:
powershell
$env:CLAWSOCKET_API_KEY="你的 API Key"这种做法的价值不只在安全性。更重要的是,GPT5.4 API接入方法一旦走环境变量,后面你给 Codex、Claude Code、OpenClaw 三套工具共用同一个入口时,配置心智会统一很多。
五、GPT5.4 API接入方法:修改 openclaw.json
这是整篇最关键的一步。
OpenClaw 当前这条链路里,真正让模型请求跑起来的,不是 Dashboard 页面,而是 ~/.openclaw/openclaw.json 里的 models.providers。
bash
openclaw config file常见默认位置通常是 Windows 的 C:\Users\你的用户名\.openclaw\openclaw.json,或者 macOS / Linux 的 ~/.openclaw/openclaw.json。
接下来把 GPT5.4 API接入方法直接写成一套清晰的 provider 结构。下面这份配置适合先把 GPT-5.4 跑起来,再顺手预留 Claude、Gemini、Grok 的切换空间:
json5
{
  gateway: {
    port: 18789,
    mode: "local",
    bind: "loopback",
    auth: {
      mode: "token",
      token: "${OPENCLAW_GATEWAY_TOKEN}"
    }
  },
  agents: {
    defaults: {
      workspace: "~/.openclaw/workspace",
      model: {
        primary: "clawsocket/gpt-5.4",
        fallbacks: [
          "clawsocket/claude-sonnet-4-5",
          "clawsocket/gemini-2.5-pro"
        ]
      },
      models: {
        "clawsocket/gpt-5.4": {},
        "clawsocket/claude-sonnet-4-5": {},
        "clawsocket/gemini-2.5-pro": {},
        "clawsocket/grok-4": {}
      }
    }
  },
  models: {
    mode: "merge",
    providers: {
      clawsocket: {
        baseUrl: "https://api.clawsocket.com/v1",
        apiKey: "${CLAWSOCKET_API_KEY}",
        api: "openai-completions",
        models: [
          { id: "gpt-5.4", name: "GPT-5.4" },
          { id: "claude-sonnet-4-5", name: "Claude Sonnet 4.5" },
          { id: "gemini-2.5-pro", name: "Gemini 2.5 Pro" },
          { id: "grok-4", name: "Grok 4" }
        ]
      }
    }
  }
}
这份配置里,你真正要盯住的是 5 个位置:baseUrl 决定统一入口地址,本文这套 GPT5.4 API接入方法用的是 https://api.clawsocket.com/v1;apiKey 负责从环境变量注入认证信息,避免把真实 Key 到处明文复制;api 这里用 openai-completions,因为兼容入口通常最好接;primary 决定默认模型,先用 clawsocket/gpt-5.4;models 则把以后准备切换的模型先列出来,后面改起来不会乱。
如果你现在只想验证 GPT5.4 API接入方法能不能跑通,也可以先把 models 和 fallbacks 缩小,只保留 gpt-5.4 一项。
六、配置写完以后,怎么判断“龙虾开始动了”
很多教程写到这里就停了,但实际使用里,最关键的不是“你有没有保存文件”,而是“OpenClaw 有没有真的读到它”。
bash
openclaw config validate
openclaw doctor
bash
openclaw gateway如果你习惯后台方式,也可以改用:
bash
openclaw gateway startbash
openclaw dashboardOpenClaw 起来以后,可以直接问一个最简单的问题,例如“现在几点”“帮我总结下面这段话”“列出当前目录”。
如果控制台能进、消息能发、模型也正常回,这就说明 GPT5.4 API接入方法这条链路基本已经通了。
再细一点看,建议你同时检查 openclaw config validate 是否通过、echo $CLAWSOCKET_API_KEY 能不能输出当前 Key、baseUrl 是否已经写成 https://api.clawsocket.com/v1,以及 Dashboard 里的对话是否不再报认证错误或 provider 错误。只要前面这些基础条件都对,消息仍然不返回,通常就不是安装问题,而是模型名、旧环境变量或者 Gateway 缓存的问题。
七、把 GPT5.4 养活以后,怎么扩到 Claude、Gemini、Grok
这其实是这套写法最有价值的地方。
很多人以为 GPT5.4 API接入方法跑通以后,换其他模型要重来一遍。其实不用。你已经有了一个统一 provider,后面只是在这套 provider 下面扩模型。
最省事的思路是让默认模型先用 clawsocket/gpt-5.4,日常写作和通用问答优先走 GPT;想测别的模型时,再把 claude-sonnet-4-5、gemini-2.5-pro、grok-4 放进同一个 provider 里,必要时再改 primary 或增加 fallbacks。
| 模型 | 更适合的场景 | 在 OpenClaw 里的用法 |
|---|---|---|
| GPT-5.4 | 通用主力、写作、总结、代码辅助 | 适合做默认 primary |
| Claude Sonnet | 长文本理解、细致改写 | 适合做 fallback |
| Gemini Pro | 多模态或 Google 生态联动 | 适合补位 |
| Grok | 补充对比测试 | 放进 provider 备用 |
这就是统一入口的意义。你不用给 OpenClaw 维护四份不同风格的配置,只要一个 clawsocket provider,就能把日常切换成本降下来。
八、最容易踩的坑
1. 改的是错文件
这类问题非常常见。你以为自己已经写好了 GPT5.4 API接入方法,实际上 OpenClaw 读的是另一份配置。先跑 openclaw config file,再去改文件,省得白忙一轮。
2. Key 已经换了,但 Gateway 还吃着旧环境变量
你在终端里 source ~/.zshrc,不代表已经运行的 Gateway 进程也同步更新了。只要你改过 Key,就顺手重启一次 Gateway,不要拿旧进程去验证新配置。
3. 模型名写对了,但 allowlist 没放行
如果你在 agents.defaults.models 里做了允许列表,那不在列表里的模型就算 provider 已经配置好,也照样切不过去。表面看起来像是 GPT5.4 API接入方法失效,实际上是模型引用没被放行。
4. 一上来就配太多东西
新手最容易犯的错,就是一开始同时改路径、换 Key、加多个模型、改认证方式、加聊天渠道。排错时你根本不知道哪一步出了问题。更稳的顺序是:先把 GPT-5.4 单独跑通,再加别的。
常见问题
我一定要先配官方 API,才能接 GPT5.4 吗
不一定。
更稳的路线通常是先跑 openclaw onboard,把底座生成出来,再按本文的 GPT5.4 API接入方法去接自定义 provider。
openclaw.json 是 JSON 还是 JSON5
按 OpenClaw 当前官方配置文档,它是 JSON5。这意味着你手改配置时会比纯 JSON 轻松一些,尤其是尾逗号和注释场景。
为什么我已经能打开控制台,模型还是不回
因为 Dashboard 能打开,只能说明 Gateway 起了,不代表 provider 一定正常。真正决定是否出字的,还是 baseUrl、apiKey、api 和模型 id。
GPT5.4 API接入方法跑通以后,还需要反复执行 onboard 吗
通常不需要。onboard 更像初始化向导,不是日常维护入口。后面你主要会改的是 openclaw.json、环境变量和默认模型。
总结
从零开始“养龙虾”,真正要做的事情并不复杂:把 OpenClaw 装好,跑 openclaw onboard,保存 dashboard token,生成自己的 API Key,再按本文的 GPT5.4 API接入方法把 provider 写进 openclaw.json,收尾启动 Gateway 并验证对话。只要这条主线走通,OpenClaw 就已经从“装好了一个 CLI”,变成“真的能工作的本地 AI 助手”。
九、把这套方法记成一张执行清单
如果你准备把这篇文章真正落地执行,可以把 GPT5.4 API接入方法记成一条固定顺序:先确认 CLI 可用,再确认 openclaw onboard 已经生成配置,再确认 token 地址能打开 Dashboard,之后才去改 openclaw.json。这样做的好处是,你不会把安装层、认证层、provider 层混在一起排查,也不会因为某一步没完成,就误判成 GPT5.4 API接入方法本身有问题。
更务实一点说,这套 GPT5.4 API接入方法最有价值的地方,不只是把 GPT-5.4 接进 OpenClaw,而是帮你形成一套以后还能继续复用的模型接入模板。今天你先接 GPT-5.4,明天想补 Claude、Gemini、Grok,本质上都还是在同一个 provider 结构里扩模型。只要 baseUrl、apiKey、api、models 这四个点没乱,GPT5.4 API接入方法后面的维护成本就会明显低很多。
如果你是给自己本机单独用,GPT5.4 API接入方法跑通以后,建议立刻做两件事:一是保留当前可用配置的备份,二是记录当前默认模型名和环境变量名。这样下次你改 provider 或换 Key 时,就知道应该回滚到哪一个版本。很多人以为是模型不稳定,实际上只是把一份能用的配置覆盖掉了,没有留下最小可用版本。
对团队来说,GPT5.4 API接入方法还可以顺手变成统一模板。一个人把结构跑通以后,其他人只需要换自己的 Key,再复用同一套 openclaw.json 结构和同一套验证动作,就能把本地环境拉齐。对文档、排错和后续培训来说,这比每个人各写一套零散笔记省事得多。
十、真正长期使用时,建议你额外做的几件事
OpenClaw 一旦进入日常使用阶段,最怕的不是“完全起不来”,而是偶发性的小问题把你拖进重复排查里。比如某次换了 Key 以后忘了重启 Gateway,某次为了测试新模型临时改了 primary,过几天又忘记自己改过什么。这些问题单看都不大,但一旦没有固定动作,后面每次出错你都得重新猜一遍。更稳的做法是把当前可用的 openclaw.json 单独备份一份,并在备注里写明当时的默认模型、环境变量名和入口地址。
如果你经常在多个模型之间切换,建议不要把所有切换动作都直接堆到默认配置里。更好的办法是先保留一个稳定的默认模型,再把其他模型作为备用项放进同一个 provider。这样你平时写作、总结、代码辅助都能有一条稳定主线;只有在需要比较效果时,才去切其他模型。对日常使用来说,这种方式比频繁改默认模型更稳,因为你不会把“测试状态”误当成“长期状态”。
当你把这些维护动作做扎实以后,OpenClaw 的体验会稳定很多。你会发现所谓“养龙虾”,真正耗时间的从来不是第一次装 CLI,而是后面有没有把环境、配置、验证、回滚这几件事做成固定流程。一旦流程固定下来,后续无论你是继续扩模型,还是把它接到其他 Agent 工具上,整体成本都会低不少。
广告:如果你不想自己维护多套模型平台和多份 Key,可以直接在 api.clawsocket.com 生成令牌,然后按上面的 GPT5.4 API接入方法接进 OpenClaw。这样后面继续扩到 Claude、Gemini、Grok 会省事很多。